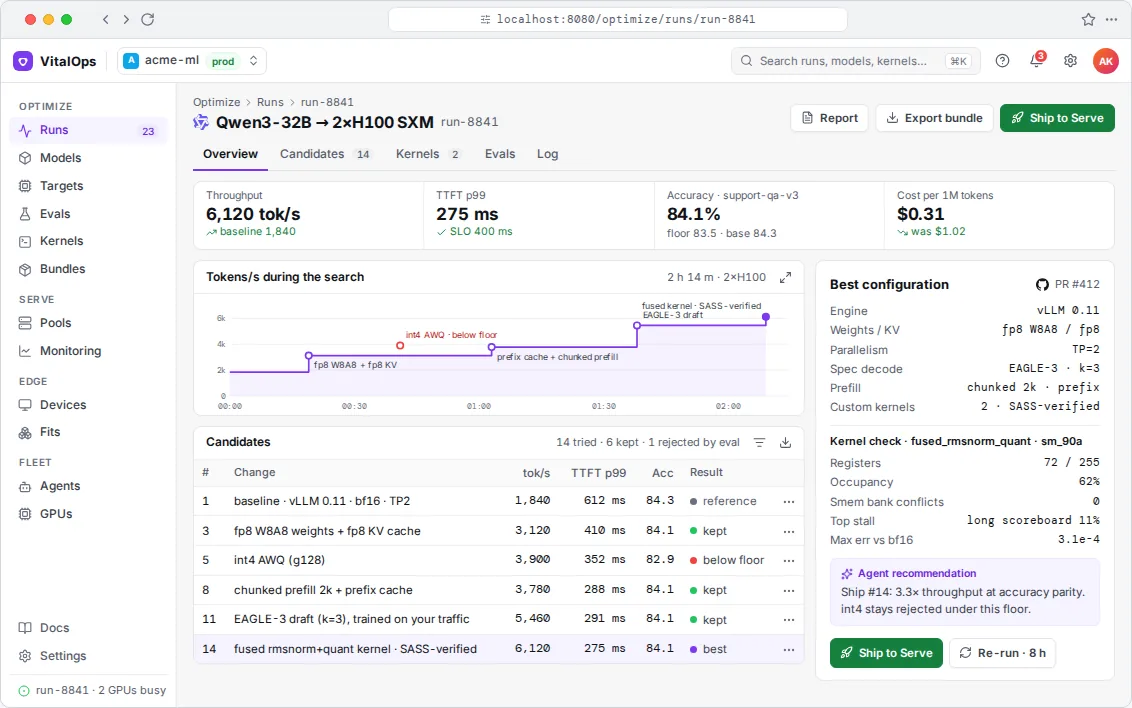
@torch.compiledef rmsnorm_q(x, w, eps=1e-6): v = x.float().pow(2).mean(-1, keepdim=True) y = x * torch.rsqrt(v + eps) * w s = y.abs().amax(-1, keepdim=True) / 448.0 return (y / s).to(torch.float8_e4m3fn), s
__global__ void rmsnorm_q(const bf16* x, const bf16* w, fp8* out, int n, float eps) { float ss = 0.f; for (int i = lane; i < n / 8; i += 32) ss += dot8(ld128(x + i)); ss = warp_reduce_sum(ss); float r = rsqrtf(ss / n + eps);.visible .entry rmsnorm_q(.param .u64 x, ...)ld.global.v4.u32 {%r4, %r5, %r6, %r7}, [%rd2];fma.rn.f32 %f12, %f5, %f5, %f12;shfl.sync.bfly.b32 %f13, %f12, 16, 31, -1;rsqrt.approx.f32 %f14, %f13;max.f32 %f15, %f15, %f16;st.global.v2.b32 [%rd6], {%r20, %r21};/*0120*/ LDG.E.128 R4, [R2.64]/*0150*/ FFMA R12, R5, R5, R12/*0180*/ SHFL.BFLY PT, R13, R12, 0x10, 0x1f/*01b0*/ MUFU.RSQ R14, R13/*0210*/ FMNMX R15, R15, R16, !PT/*0240*/ F2FP.E4M3.PACK_AB R20, R19, R18/*0270*/ STG.E.64 [R6.64], R20